

これ、全部承認制にしたらAIエージェントを入れる意味がないですよね。でも全自動にするのは怖いです
月曜朝の会議室でそう話したのは、業務企画部で請求処理の自動化を進める佐伯さん(仮名)でした。筆者もその場に同席していましたが、この一言には、多くの企業がAIエージェント導入で直面する迷いが表れていました。
情シスの担当者はログの追跡性を気にし、経理マネージャーは誤送信や金額ミスを心配し、現場メンバーは「確認待ち」が増えることを懸念していました。以前は、AIエージェント承認フローを決めきれず、すべてを人間承認に寄せるか、限定範囲だけ全自動にするかの二択になりがちでした。
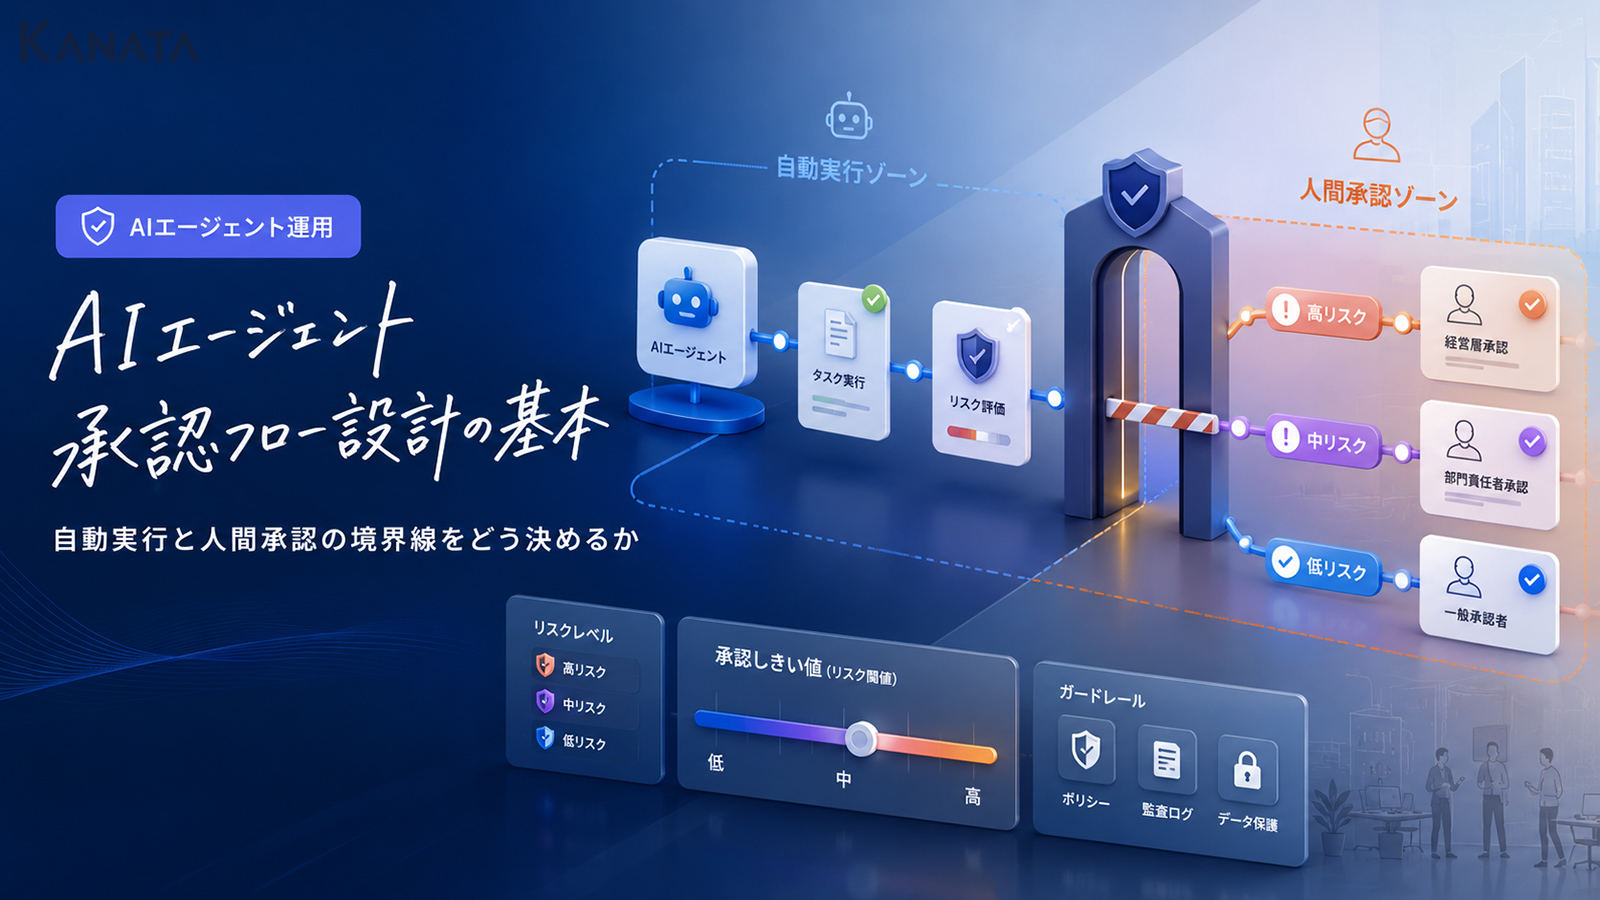
しかし現在は、申請金額、取引先種別、過去の例外件数、外部送信の有無などをもとにリスク等級を分け、低リスク業務は自動実行、高リスク業務はダブルチェック、中間は閾値超過時のみ承認という考え方で、AIによるワークフロー設計を進める企業も出てきています。Kanataのように、プロジェクト単位で利用者・データ・AI機能を整理できる業務支援プラットフォームを使う場合も、承認ポリシー、承認者ロール、ガードレールを先に定義しておくことで、AIエージェントを止めすぎず、任せすぎない運用を設計しやすくなります。
この記事では、自動実行における人間承認の適用範囲をどう決めるかを、業務リスクに応じた自動化レベルとして整理します。目指すのは、現場が毎回迷わず、監査や情シスにも説明できる承認フローです。ただし、承認設計だけで事故をゼロにできるわけではありません。ログ管理、教育、定期的な見直しとあわせて、自社の業務に合う線引きを考えていきましょう。
AIエージェントの承認フロー設計で最初に決めるべきこと

業務実行AIエージェントの導入で最初に起きやすい混乱は、「AIに何を任せるか」だけではありません。「AIが実行する前に、誰がどの条件で止められるか」です。
文章の下書きや議事録の要約であれば、出力を見て人が修正できます。しかし、業務実行AIエージェントは違います。メールを送る、社内システムに入力する、申請を起票する、顧客情報を更新する、請求データを転記する。こうした操作は、実行された瞬間に業務プロセスの一部になります。
筆者はAI導入支援の現場で、何度もこの論点に立ち会ってきました。技術的には自動化できる。API連携もできる。画面操作も自動化できる。けれど、最後の一歩で「本当にAIが押していいのか」という問いが残ります。
この問いを避けたまま開発を進めると、後から運用で止まります。
AIエージェント承認フローを設計するときは、まず次の3つを分けて考える必要があります。
- AIが判断してよい範囲です。たとえば、過去のルールに沿って入力内容を分類する、必要書類の不足を検知する、定型フォーマットに変換する、といった作業です。
- AIが実行してよい範囲です。社内メモの作成、下書き保存、承認依頼の起票など、失敗しても取り消しや修正がしやすい作業が該当します。
- 人間承認を必ず挟む範囲です。社外送信、金額確定、契約条件の変更、顧客データの上書き、権限変更など、影響範囲が大きい操作です。
ここを曖昧にしたまま実装すると、現場では「結局どこまでAIに任せていいのか」が分からなくなります。その結果、AIエージェントを導入しても、すべての操作を人が確認する運用になり、期待した業務効率は出にくくなります。
一方で、「効率化したいから」といって最初から全自動に寄せると、誤送信や誤入力が起きたときに、誰がどの判断をしたのかを説明できなくなります。承認フロー設計は、AIを止めるための仕組みではありません。AIに任せる範囲と、人が責任を持つ範囲を明確にするための設計です。
「全部承認」と「全部自動」の二択から抜け出す

業務AI承認の議論では、よく2つの極端な意見が出ます。
1つは、「リスクがあるから全部人が承認すべき」という考え方です。もう1つは、「AIエージェントを入れるなら、できるだけ全自動にしないと意味がない」という考え方です。
どちらにも合理性があります。請求、契約、人事、顧客対応のようにミスの影響が大きい業務では、人間承認を入れたくなるのは自然です。一方で、毎回同じような確認を人が行っているだけなら、AIエージェントの価値は出にくくなります。
筆者が現場でよく伝えるのは、「業務名だけで判断しないでください」ということです。
たとえば、「請求処理は危ないからAIに任せられない」と一括りにしてしまうと、ほとんど前に進みません。しかし、同じ請求処理でも、「請求書のファイル名をルールに沿って変更する」作業と、「請求金額を確定して取引先に送信する」作業では、リスクの大きさが違います。
同じ顧客対応でも、「FAQ候補を下書きする」作業と、「顧客に回答メールを送る」作業では、必要な承認レベルが違います。
つまり、承認フローは業務単位ではなく、操作単位で設計する必要があります。
たとえば、次のように分けると議論が進みやすくなります。
- 情報を読むだけの操作
- 下書きを作る操作
- 社内システムに一時保存する操作
- 社内の関係者に通知する操作
- 社外に送信する操作
- 金額、契約、権限、顧客データを変更する操作
このように操作を分解すると、「すべて承認」でも「すべて自動」でもない、中間の設計が可能になります。低リスクの操作は自動実行し、影響が大きい操作だけ人間承認を入れる。これが、AIエージェント承認フローの基本です。
現場で議論が止まっているときほど、筆者はホワイトボードに業務プロセスを書き出します。そして、ひとつずつ「これは読むだけか」「これは書き換えるのか」「これは外に出るのか」と確認していきます。抽象的な不安は、操作に分解すると扱えるリスクに変わります。
自動実行と人間承認の境界線を決める5つの判断軸

自動実行と人間承認の境界線は、感覚で決めると属人化します。ある部署では自動実行できるのに、別の部署ではすべて手動確認になる。ある担当者はAIを信頼しているのに、別の担当者は毎回差し戻す。こうしたばらつきが起きると、AIエージェントは業務基盤として定着しにくくなります。
承認フローを安定させるには、判断軸を明文化することが必要です。
金額・件数・影響範囲
最も分かりやすい判断軸は、金額や件数です。
たとえば、経費精算、請求処理、発注処理では、金額が大きくなるほど承認レベルを上げる設計が考えられます。少額の定型処理はAIが自動実行し、一定金額を超えた場合は上長承認を求める。さらに高額な場合は、部門長や管理部門の承認を追加する、といった形です。
ただし、金額だけで判断すると見落としが出ます。少額でも大量件数を一括処理する場合は、影響範囲が大きくなるためです。1件あたりの金額、対象件数、総額、対象顧客数などを組み合わせて見る必要があります。
筆者がある企業で支援したときも、最初は「1件あたりの金額」だけで閾値を作ろうとしていました。しかし、実際には小額の更新を多数まとめて実行する業務があり、総影響額で見ると無視できない規模でした。承認フローでは、単価だけでなく、処理の塊としての影響を見ることが大切です。
社外送信・外部システム操作の有無
社外に情報が出る操作は、承認レベルを高く設定するのが基本です。
AIが作成したメールを社内下書きとして保存するだけなら、リスクは限定的です。しかし、顧客に送信する、取引先ポータルに登録する、外部広告アカウントに反映する、といった操作は、外部に影響が出ます。
この場合、AIエージェントができるのは「送信直前まで準備する」ことにとどめ、人間承認を経て実行する設計が現実的です。
特に顧客接点では、「内容が合っているか」だけでなく、「このタイミングで送ってよいか」「この言い方で関係性を損なわないか」という判断が入ります。ここは、AIよりも人間が文脈を読み取るべき領域です。
個人情報・機密情報の取り扱い
個人情報、契約情報、未公開情報、顧客の機密情報を扱う業務では、AIエージェントの自動化レベルを慎重に決める必要があります。
特に、情報を加工するだけでなく、転記、共有、送信、権限付与を伴う場合は注意が必要です。AIが誤って別の相手に送る、不要な情報まで含める、参照してはいけないデータを参照する、といったリスクがあるためです。
この領域では、ガードレールとして「特定のデータ項目を含む場合は必ず承認」「機微情報を検知したら自動停止」「送信前にマスキング状態を確認」といったルールを設けることが重要です。
Kanataを利用する場合も、個人情報や機密情報を扱う際は、入力前にマスキングし、社内で管理されたプロジェクト内で扱い、外部に出る出力は人が確認してから利用することが前提になります。AIに任せる前に、そもそもAIへ渡してよい情報かを確認する。この一段階を省かないことが、業務AIにおける承認の土台になります。
やり直し可能性
失敗しても簡単に取り消せる業務と、取り消しが難しい業務では、承認フローを変えるべきです。
たとえば、社内メモの生成や下書き保存は、後から修正できます。一方で、顧客への送信、契約条件の反映、請求金額の確定、アカウント権限の変更は、取り消しに手間がかかります。場合によっては、顧客対応や監査対応が必要になります。
やり直しが難しい操作ほど、人間承認やダブルチェックを入れる意味が大きくなります。
筆者はよく、「戻せるかどうかで考えましょう」と伝えます。AIの精度だけを議論していると、話が抽象的になります。しかし、「失敗したときに戻せるか」と問うと、業務側も情シス側も判断しやすくなります。
例外処理の多さ
AIエージェントは、ルールが明確で、例外が少ない業務に向いています。逆に、判断基準が曖昧で、担当者の経験に依存する業務では、最初から自動実行に寄せすぎない方が安全です。
たとえば、「この取引先は通常ルールと違う」「この顧客だけ特別条件がある」「この時期だけ運用が変わる」といった例外が多い業務では、AIが誤った一般化をする可能性があります。
この場合、AIには候補作成や論点整理までを任せ、最終実行は人が行う設計が向いています。運用を重ねて例外パターンが整理できた段階で、自動化レベルを上げていく方が現実的です。
AI導入では、最初から大きな業務を丸ごと自動化したくなります。しかし、筆者の経験上、最初に向いているのは「例外が少ない小さな処理」です。小さく任せて、ログを見て、徐々に任せる範囲を広げる。この順番を守るだけで、導入後の混乱は減らしやすくなります。
リスク等級で承認フローを整理する

判断軸を洗い出したら、次はリスク等級に落とし込みます。リスク等級とは、業務操作をリスクの大きさに応じて分類し、それぞれに承認ルールを設定する考え方です。
ここでは、4段階で考えると整理しやすくなります。
| リスク等級 | 対象業務の例 | 承認フローの考え方 |
|---|---|---|
| レベル1:自動実行してよい業務 | 社内メモの整理、定型フォーマットへの変換、ファイル名の整形、既存データの分類など | 毎回承認ではなく、ログを残して後から確認できる状態にする |
| レベル2:条件付きで自動実行してよい業務 | 過去に同じ処理実績がある、金額が一定以下、対象が社内に限定される処理など | 閾値を超えた場合のみ人間承認に回す |
| レベル3:人間承認が必要な業務 | 顧客へのメール送信、請求データの確定、広告配信設定の変更、人事関連の通知など | AIが候補を作成し、人が承認してから実行する |
| レベル4:AIエージェントに実行させない業務 | 最終的な人事評価の確定、重大な契約条件の判断、法的責任を伴う意思決定、経営判断そのものなど | AIは論点整理や比較表作成などの補助にとどめ、最終判断や実行は人が担う |
レベル1:自動実行してよい業務
レベル1は、AIエージェントが自動実行してもよい業務です。
たとえば、社内メモの整理、定型フォーマットへの変換、ファイル名の整形、社内向け通知の下書き作成、既存データの分類などです。失敗しても修正しやすく、外部への影響が限定的な操作が該当します。
このレベルでは、人間承認を毎回挟むよりも、ログを残し、後から確認できる状態にする方が実務的です。承認ではなく、記録とモニタリングを重視します。
筆者の感覚では、このレベルの業務まで承認対象にしてしまうと、現場はすぐに疲れます。AIが整えたファイル名や社内メモを毎回承認するような運用では、AIエージェントは便利な仕組みではなく、手続きの多い仕組みに見えてしまいます。
レベル2:条件付きで自動実行してよい業務
レベル2は、一定条件を満たす場合に限り、自動実行してよい業務です。
たとえば、過去に同じ処理実績がある、金額が一定以下である、対象が社内に限定されている、参照データが最新である、といった条件です。条件を満たしている間はAIが実行し、条件から外れた場合だけ人間承認に回します。
この設計では、閾値が重要になります。金額、件数、差分、信頼度、例外フラグなど、何を超えたら承認に回すのかを明確にする必要があります。
この「閾値超過時だけ承認」という考え方は、現場定着において重要です。すべてを人が見るのではなく、見るべきものだけを見る。AIエージェントの価値は、この絞り込みができて初めて出てきます。
レベル3:人間承認が必要な業務
レベル3は、AIが実行候補を作成し、人が承認してから実行する業務です。
顧客へのメール送信、契約関連文書の更新、請求データの確定、広告配信設定の変更、人事関連の通知など、影響範囲が大きい操作が該当します。
このレベルでは、承認者が何を確認すべきかを明確にしておくことが重要です。AIが出した内容を全文読み直すだけでは、承認負荷が大きくなります。差分、根拠、例外、リスク判定、推奨理由をAI側で整理し、承認者は判断に必要な情報だけを確認できるようにします。
たとえば、AIエージェントが承認依頼を出すときに、次のような情報を添えると実務で使いやすくなります。
- 実行しようとしている操作
- 参照したデータ
- 前回との差分
- 閾値に該当した理由
- 想定されるリスク
- 承認者に確認してほしい項目
承認者が「何を見ればよいか分からない」状態をなくすことが、承認フローを形骸化させない第一歩です。
レベル4:AIエージェントに実行させない業務
レベル4は、AIエージェントに実行させない業務です。
たとえば、最終的な人事評価の確定、重大な契約条件の判断、法的責任を伴う意思決定、個人の権利に大きく影響する判断、経営判断そのものなどです。
この領域では、AIは補助にとどめるべきです。論点整理、比較表作成、リスク洗い出し、過去事例の検索などには活用できますが、最終判断や実行は人が担います。
AIエージェントの活用範囲を広げることと、すべてをAIに実行させることは同じではありません。むしろ、実行させない領域を明確にすることで、安心して任せられる領域が広がります。
筆者は、AI導入を支援するときに「AIに任せないことリスト」を作ることがあります。一見すると後ろ向きに見えますが、実際には逆です。任せない領域が明確になるからこそ、任せる領域で自動化を進めやすくなります。
承認者ロールを設計する

承認フローで見落とされやすいのが、承認者ロールです。
「誰かが承認する」という曖昧な設計では、運用が始まったあとに詰まりやすくなります。承認依頼が誰に飛ぶのか、承認者が不在の場合はどうするのか、承認者は何に責任を持つのか。これらを決めておかないと、AIエージェントは実行直前で止まり続けます。
承認者ロールは、少なくとも次のように分けて考えるとよいでしょう。
- 現場承認者
- 業務内容が実態に合っているかを確認します。請求処理であれば、対象取引、金額、納品状況、顧客との合意内容などを確認します。
- 業務責任者
- 個別処理の正しさだけでなく、ルールに沿っているか、例外処理として扱うべきか、組織として許容できるかを判断します。
- 情シス・情報セキュリティ担当
- アクセス権、ログ、データ連携、外部送信、システム権限などを確認します。
- 監査・管理部門
- 後から説明可能な運用になっているかを確認します。承認者、判断根拠、差し戻し状況などのログが重要になります。
現場承認者
現場承認者は、業務内容が実態に合っているかを確認します。
たとえば、請求処理であれば、対象取引、金額、納品状況、顧客との合意内容などを見ます。AIが形式的には正しい処理をしていても、現場の文脈とずれていれば差し戻す役割です。
現場承認者には、業務の肌感覚があります。筆者はこの肌感覚を軽視すべきではないと考えています。AIがどれだけルールを読めても、「この取引先は今月だけ少し特殊です」といった文脈は、現場が持っていることが多いからです。
業務責任者
業務責任者は、その業務プロセス全体の妥当性を確認します。
個別処理の正しさだけでなく、ルールに沿っているか、例外処理として扱うべきか、組織として許容できるかを判断します。中リスク以上の処理では、現場承認者と業務責任者を分けることで、ダブルチェックが機能しやすくなります。
業務責任者の役割は、単に「承認する人」ではありません。承認フローそのものを改善する人でもあります。差し戻しが多い処理を見つけ、ルールを見直し、自動化レベルを調整する。この運用改善まで含めて責任範囲に入れると、AIエージェントは育っていきます。
情シス・情報セキュリティ担当
情シスや情報セキュリティ担当は、アクセス権、ログ、データ連携、外部送信、システム権限などを確認します。
AIエージェントがどのシステムに接続し、どのデータを参照し、どの操作を実行できるのかは、業務部門だけでは判断しきれません。特に、社外サービスや外部APIと連携する場合は、技術面の承認が必要です。
筆者はエンジニアとして開発現場にいた経験もあるため、ここは強く感じます。業務側が「このくらい自動化したい」と思っても、裏側では権限設計、監査ログ、API制限、障害時のリカバリなど、技術的に見るべき点が多くあります。情シスはブレーキ役ではなく、安全に走らせるための設計者です。
監査・管理部門
監査や管理部門は、後から説明可能な運用になっているかを確認します。
誰が承認したのか、AIは何を根拠に候補を作ったのか、差し戻しはどの程度発生したのか。こうしたログが残っていないと、問題が起きたときに原因を追えません。
承認者ロールを設計するときは、「偉い人に承認してもらう」ではなく、「その判断に必要な責任と情報を持つ人が承認する」と考えることが大切です。
ガードレールは承認前・実行中・実行後に置く

AIエージェントのガードレールというと、実行前の承認だけを想像しがちです。しかし、実際には承認前、実行中、実行後の3か所にガードレールを置く必要があります。
この考え方は、AIガバナンスの国際的な議論とも整合します。たとえばNISTのAI Risk Management Frameworkは、AIリスクを「Govern」「Map」「Measure」「Manage」の機能で管理する考え方を示しています。また、EU AI Actでは高リスクAIシステムに対して人による監督の重要性が示されています。
承認前のガードレール
承認前のガードレールは、AIが作成した実行案を人に見せる前に、不適切な内容を検知する仕組みです。
たとえば、必須項目が欠けている、金額が通常範囲から外れている、宛先が社外になっている、個人情報が含まれている、参照データが古い、といった条件です。
ここで検知できれば、承認者に不要な確認を回さずに済みます。AIエージェント自身が「この条件では実行できません」「承認が必要です」と判断できる状態を作ることが重要です。
筆者は、この段階を「AIに自制心を持たせる設計」と呼ぶことがあります。もちろんAIに本当の意味での自制心があるわけではありません。けれど、実行条件と停止条件を明確にしておくことで、危ない場面で止まる仕組みは作れます。
実行中のガードレール
実行中のガードレールは、AIエージェントが処理を進めている途中で異常を検知し、停止する仕組みです。
たとえば、予定より多くの件数を処理しようとしている、同じ顧客に複数回通知しようとしている、通常とは異なるシステム項目を書き換えようとしている、といったケースです。
人間の業務でも、途中で違和感があれば手を止めます。AIエージェントにも同じように、異常時に止まる条件を持たせる必要があります。
特に業務実行AIエージェントでは、「実行前は問題なかったが、途中で想定外のデータに出会う」ことがあります。だからこそ、開始前の承認だけでは不十分です。途中で止まれることも、重要なガードレールです。
実行後のガードレール
実行後のガードレールは、結果を記録し、後から確認できるようにする仕組みです。
どの業務を、いつ、どのAIエージェントが、どのデータをもとに、誰の承認で実行したのか。実行結果は成功したのか、差し戻されたのか、修正されたのか。これらをログとして残すことで、運用改善が可能になります。
ガードレールは、AIの行動を制限するだけのものではありません。むしろ、AIエージェントを安心して業務に組み込むための操作環境です。
筆者は、AIエージェントのログを「責任追及のための記録」だけとは考えていません。もちろん監査やトラブル対応には必要です。しかしそれ以上に、ログは改善の材料です。どこで止まったのか。どこで人が修正したのか。どの閾値が厳しすぎたのか。これらを見れば、次の設計が見えてきます。
Kanataを使う場合の承認フロー設計の考え方

AIエージェント基盤を構築する方法は、専用開発、既存SaaSの活用、RPAとの連携、社内ポータルへの組み込みなど複数あります。その中でKanataを使う場合は、承認フローを単独の機能としてではなく、業務ルール、プロンプト、学習データ、権限、ログと一体で考えることが重要です。
たとえば、AIエージェントに請求処理を任せる場合、必要なのは「承認ボタン」だけではありません。請求処理のルール、例外条件、参照すべき社内ルール、承認者ロール、承認依頼時に表示する要約、実行後のログが必要です。
Kanataでは、プロジェクトごとに利用者、データ、AI機能を整理し、業務単位で安全に共同作業できる環境を作ることができます。また、AIチャット、AI要約、eラーニングなどの機能を組み合わせ、業務に必要な知識やプロンプトをチーム内で再利用しやすい形に整えることができます。
業務AIの承認を設計するなら、次のような流れが考えられます。
- プロジェクト単位で対象業務を整理します。営業、経理、人事、カスタマーサクセスなど、扱う情報と関係者が異なる業務は、プロジェクトを分ける方が管理しやすくなります。
- プロジェクト内に業務ルールや参照資料を登録します。AIエージェントが何を根拠に判断するのかを明確にするためです。同じ資料を毎回貼り付けるのではなく、チームで使う知識として整備しておくことで、AIの出力も安定しやすくなります。
- AIチャットや業務実行エージェントに、承認前の確認項目、実行可能な範囲、禁止事項、例外時の停止条件を設定します。
- 承認フローを運用しながら、差し戻し理由や例外処理を見直します。最初から完璧な承認設計を作るのではなく、ログを見ながら自社の業務に合わせて育てていくことが現実的です。
弊社が提供するKanataは、AIを単発の便利ツールとして使うよりも、業務ルール、利用者、データ、プロンプトをプロジェクト単位で整理しながら運用したい企業に向いています。AIエージェントの承認フローも同じです。個人の判断に頼るのではなく、組織として再利用できるルールに落とし込むことで、現場に定着しやすくなります。
承認フローを形骸化させないための運用ポイント

承認フローは作っただけでは機能しません。むしろ、設計が重すぎると、現場は抜け道を探し始めます。
- 毎回承認が必要で面倒だから、AIを使わずに手作業で進める
- 承認者が内容を見ずに承認ボタンだけ押している
- 差し戻し理由が残らないので、同じミスが繰り返される
こうした状態になると、承認フローはガードレールではなく、形式的な手続きになります。
形骸化を防ぐには、次の3つが重要です。
承認者が見る項目を絞る
承認者にすべてを確認させると、負荷が高くなります。AIエージェント側で、変更点、リスク判定、参照元、例外条件、推奨理由をまとめ、承認者は判断に必要なポイントだけを見られるようにします。
承認画面で確認すべき項目が多すぎると、結局誰も読まなくなります。
筆者はプロダクト開発の現場で、管理画面や承認画面を設計することもあります。そのときにいつも意識するのは、「人は忙しい状態で判断する」という前提です。理想的な状態でじっくり読んでくれることを期待してはいけません。忙しくても判断できるように、見るべき情報を絞る必要があります。
差し戻し理由を蓄積する
差し戻しは、単なる失敗ではありません。承認フローを改善するための重要なデータです。
どの条件で差し戻しが多いのか。AIの判断がずれているのか。業務ルールが曖昧なのか。承認者によって判断が分かれているのか。差し戻し理由を蓄積することで、閾値やポリシーを見直せます。
たとえば、同じ理由で何度も差し戻されているなら、AIへの指示や参照データが不足している可能性があります。承認者ごとに判断が分かれているなら、業務ルールそのものが曖昧なのかもしれません。
差し戻しを責めるのではなく、改善の材料として扱う。この姿勢が、AIエージェント運用では欠かせません。
定期的に自動化レベルを見直す
最初は人間承認を多めに入れても構いません。重要なのは、運用後に見直すことです。
一定期間、差し戻しがほとんどない処理は、条件付き自動実行に移せるかもしれません。逆に、自動実行後の修正が多い処理は、承認レベルを上げる必要があります。
AIエージェントの承認フローは、一度作ったら終わりではありません。業務ルール、担当者、システム、顧客条件が変われば、承認設計も変わります。
筆者は、AI導入を「システムを入れるプロジェクト」ではなく、「業務を育てるプロジェクト」だと捉えています。AIエージェントも、最初から完成形を求めるより、運用しながら精度とルールを育てていく方がうまくいきます。
よくある失敗例

ここでは、AIエージェント承認フローで起きやすい失敗を整理します。
承認ポイントが多すぎる
すべての操作に承認を入れると、現場の作業は止まります。AIエージェントが下書きを作り、人が確認し、別の人が承認し、さらに管理者が確認する。これでは、手作業より遅くなる場合があります。
承認は、多ければ安全になるわけではありません。重要なポイントに絞るからこそ機能します。
筆者が見る限り、慎重な企業ほどこの失敗に陥りやすい傾向があります。もちろん慎重さは大切です。ただ、すべてのリスクを承認で受け止めようとすると、承認者がボトルネックになります。リスクの低い操作はログで管理し、重要な操作だけ人が見る。この切り分けが必要です。
承認者が責任を理解していない
承認ボタンを押す人が、「自分は何に責任を持っているのか」を理解していないケースもあります。
内容の妥当性を見るのか、金額を見るのか、顧客影響を見るのか、セキュリティを見るのか。確認範囲が曖昧だと、承認は形式化します。
「とりあえず上長承認」という設計は、分かりやすいようで危険です。上長がすべての業務詳細を把握しているとは限りません。承認者は役職だけでなく、判断に必要な情報を持っているかどうかで決めるべきです。
AIの判断根拠が見えない
AIエージェントが「承認不要」と判断しても、その理由が分からなければ、人は安心して任せられません。
どのポリシーに合致したのか、どの閾値を下回ったのか、どのデータを参照したのか。判断根拠を表示することで、承認者や監査部門が説明しやすくなります。
AIの判断は、ブラックボックスに見えた瞬間に信頼を失います。逆に、根拠が見えていれば、多少のミスがあっても改善できます。「なぜそう判断したのか」を残すことは、AIエージェント運用の信頼性を支える基本です。
例外処理を想定していない
通常処理だけを前提に承認フローを作ると、例外が出た瞬間に現場が止まります。
取引先ごとの特別条件、急ぎ対応、担当者不在、システム障害、データ不足など、例外は発生します。例外時にAIが止まるのか、誰にエスカレーションするのかを決めておく必要があります。
筆者は、業務設計の打ち合わせで必ず「例外は何ですか」と聞きます。すると、最初は「ほとんどありません」と返ってくることがあります。しかし、現場担当者に聞くと、たいてい例外は複数出てきます。AIエージェントの承認フローは、きれいな標準業務だけでなく、泥臭い例外まで含めて設計する必要があります。
AIエージェントの承認フロー設計チェックリスト

自社でAIエージェントの承認フローを設計する際は、次の観点を確認します。
業務分解
- 対象業務を操作単位まで分解しているか
- AIが読む、作る、保存する、送信する、更新する操作を分けているか
- 取り消し可能な操作と、取り消しにくい操作を区別しているか
リスク等級
- 金額、件数、影響範囲を判断軸にしているか
- 社外送信や外部システム操作を別扱いにしているか
- 個人情報、機密情報を含む場合の停止条件を決めているか
- 例外処理が多い業務を高リスクとして扱っているか
閾値
- どの条件を超えたら承認に回すかを明文化しているか
- 閾値の根拠を説明できるか
- 閾値を定期的に見直す運用があるか
承認者ロール
- 誰が何を承認するかを決めているか
- 承認者不在時の代理ルールがあるか
- ダブルチェックが必要な業務を定義しているか
- 承認者が見るべき項目を絞っているか
ガードレール
- 実行前のチェック条件があるか
- 実行中に異常検知して止まる条件があるか
- 実行後のログが残るか
- 差し戻し理由を蓄積できるか
運用改善
- 承認待ち件数を見ているか
- 差し戻し件数と理由を見ているか
- 自動実行してよい範囲を定期的に見直しているか
- 現場、情シス、管理部門で改善会議を行っているか
このチェックリストは、単なる確認表ではありません。AIエージェントを「便利な自動化ツール」から「説明可能な業務基盤」へ変えるための設計項目です。
まとめ:承認フローは、AIエージェントを止める仕組みではなく任せ方の設計です

業務実行AIエージェントを導入するとき、最も大切なのは「どこまで自動化できるか」だけではありません。「どこから人が責任を持つか」を同時に決めることです。
全部承認制にすれば、たしかに安心感はあります。しかし、確認待ちが増え、AIエージェントの価値は出にくくなります。一方で、全自動に寄せすぎると、誤送信、誤入力、説明責任の欠如といったリスクが大きくなります。
必要なのは、業務リスクに応じて自動化レベルを変えることです。
低リスクの操作は自動実行する。中リスクの操作は閾値を超えたら人間承認に回す。高リスクの操作は承認者ロールを明確にし、必要に応じてダブルチェックする。そして、AIに実行させない領域もあらかじめ決める。
この線引きができて初めて、AIエージェントは現場で安心して使える業務基盤になります。
ただし、承認フローは一度作って終わりではありません。業務ルール、組織体制、扱うデータ、顧客条件が変われば、適切な承認設計も変わります。ログを見ながら、差し戻し理由を分析し、少しずつ自動化レベルを調整していくことが重要です。
筆者は、AIエージェントの承認フロー設計とは、AIを信用するかしないかの議論ではないと考えています。どの業務を、どの条件で、誰の責任のもとで任せるかを決める、業務設計そのものです。
技術だけを見れば、AIエージェントにできることは今後さらに増えていきます。しかし、企業の現場で本当に重要なのは、「できること」をすべて実行することではありません。事業成果、現場定着、運用負荷、費用対効果、そしてリスクを見ながら、自社にとってちょうどよい任せ方を設計することです。
Q&A
AIエージェントの承認フローは、どの業務から作るべきですか?
まずは、例外が少なく、失敗しても修正しやすい業務から設計するのが現実的です。社内メモの整理、定型フォーマット変換、下書き作成、社内向け通知などが候補になります。いきなり契約、請求、人事評価のような高リスク業務から始めると、承認設計が重くなり、現場定着が難しくなります。
自動実行と人間承認の境界線は、誰が決めるべきですか?
業務部門だけ、情シスだけで決めるのは避けた方がよいです。業務内容を知る現場担当者、責任を持つ業務責任者、システム・権限・ログを見る情シス、必要に応じて監査や管理部門が参加して決めるのが望ましいです。承認フローは、業務設計とリスク管理の両方に関わるためです。
承認者が多いほど安全になりますか?
必ずしもそうではありません。承認者が多すぎると、確認待ちが増え、誰も内容を十分に見ない形式的な承認になりやすくなります。重要なのは、承認人数を増やすことではなく、どのリスクを誰が確認するのかを明確にすることです。高リスク業務ではダブルチェックが有効な場合もありますが、低リスク業務まで同じ扱いにすると運用負荷が高くなります。
AIエージェントの判断根拠は、どこまで残すべきですか?
少なくとも、実行日時、対象業務、参照データ、判断に使ったルール、閾値に該当した理由、承認者、実行結果は残すことが望ましいです。すべてを細かく記録しすぎると運用が重くなるため、業務リスクに応じて記録項目を調整します。監査やトラブル対応だけでなく、承認フローの改善にも使える形で残すことが重要です。
Kanataは承認フロー設計でどのように使えますか?
Kanataは、プロジェクト単位で利用者、データ、AI機能を整理し、業務ルールやプロンプトをチームで再利用しやすくする用途に向いています。承認フローを設計する際は、対象業務ごとにプロジェクトを分け、参照資料や判断ルールを整理し、AIが何を根拠に出力するのかを明確にすることで、運用しやすくなります。ただし、承認権限やログ保存の要件は企業ごとに異なるため、自社のセキュリティポリシーや既存システムとの整合性を確認する必要があります。