

便利なのは分かるのですが、社員に“何を入れてはいけないか”をどこまで細かく決めるべきか判断できません。
社内会議で、情報システム部の担当者からこのような声が上がっていました。
筆者は、AI導入や業務改革の相談を受ける中で、この種類の問いに何度も出会ってきました。生成AIの話になると、現場は「使えば早くなる」と感じます。一方で、情シスは情報漏洩を心配し、法務は著作権や契約上の扱いを確認したくなり、コンプライアンス部門は個人情報や社内規程との整合性を気にします。さらに、部長クラスのマネジメント層は「現場に任せすぎるのも怖いが、止めすぎると活用が進まない」と感じています。
以前は、生成AIの利用は一部の社員が個人判断で試す段階にとどまっていました。メール文の下書き、議事録の要約、文章の言い換えなど、比較的軽い用途が中心だったはずです。ところが現在は、社内規程、顧客との商談メモ、契約書の一次確認、研修資料の作成など、業務の中核に近い情報をAIに扱わせたい場面が増えています。
この変化は、単に「便利なツールが増えた」という話ではありません。企業の中で、AIが個人の作業補助から、組織の情報活用基盤へ移り始めているということです。だからこそ、ルールの作り方も変える必要があります。
本記事では、生成AI利用時に問題になりやすい「情報漏洩」「著作権」「個人情報」の3領域について、業務で起きやすいケースと社内ルール化の出発点を整理します。目指すのは、社員がAIを一律に恐れるのではなく、入力してよい情報、確認すべき出力、人が最終判断すべき領域を判断できる状態です。ただし、ルール文書を作るだけで安全な運用が完成するわけではありません。教育、権限管理、相談先の整備、定期的な見直しとあわせて、自社の業務に合う線引きを考えていきましょう。
生成AIの社内利用で「禁止」だけでは運用が進まない理由
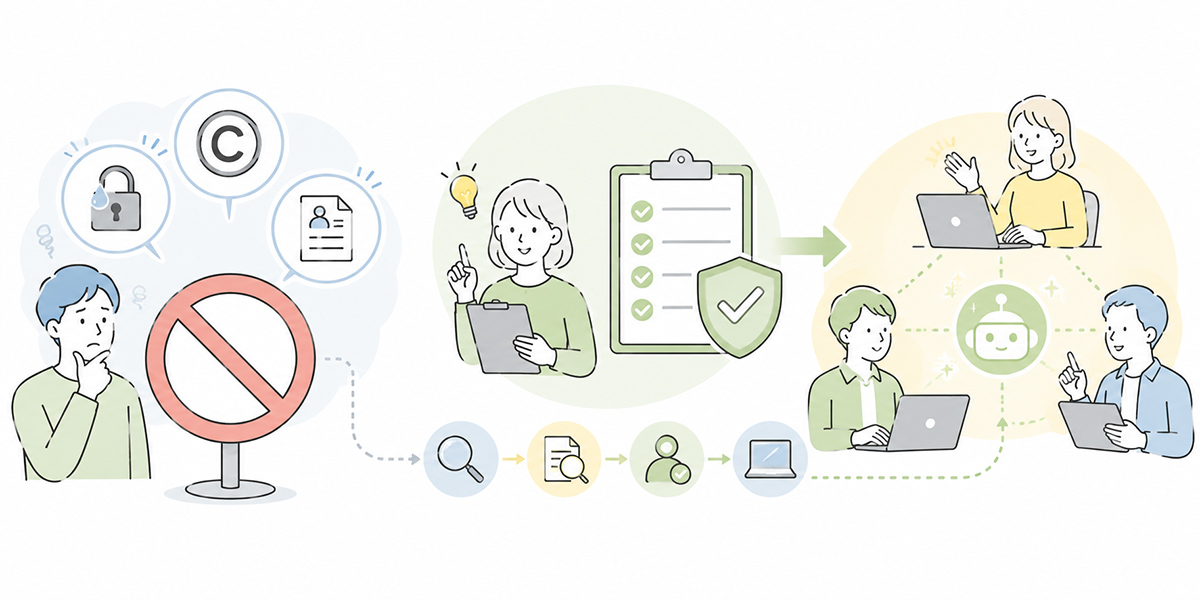
生成AIの社内ルールを考えるとき、最初に起こりやすいのが「危ない情報は入れないでください」という注意喚起だけで終わってしまうことです。
もちろん、機密情報や個人情報の取り扱いには慎重さが必要です。しかし、禁止だけを強調すると、現場では次のような疑問が残ります。
- 議事録の要約は使っていいのか
- 顧客名を伏せれば商談メモを入れてよいのか
- 社内規程を読み込ませてFAQ化するのは問題ないのか
- AIが作った文章をそのまま提案書に使ってよいのか
こうした問いに答えられないままでは、現場は使うことも止めることもできません。結果として、便利だと感じた社員だけが個人判断で使い、管理部門が実態を把握できない状態になりやすくなります。
筆者が企業のAI活用支援に入るとき、最初に見るのはツールの種類ではありません。まず確認するのは、「現場がどの業務でAIを使いたがっているのか」「その業務にはどの種類の情報が含まれるのか」「誰が最終責任を持つのか」です。
社内ルールの目的は、生成AIの利用を一律に止めることではありません。むしろ、業務で使う場面が増えるからこそ、使ってよい範囲、確認が必要な範囲、使ってはいけない範囲を明確にすることが重要です。
総務省・経済産業省の「AI事業者ガイドライン」は、AIを開発・提供・利用する各主体に向けて、リスク管理やガバナンス、関係者とのコミュニケーションを含む考え方を整理しています。2026年8月時点では第1.2版が公表され、チェックリストやワークシートも提供されています。
また、日本では2025年に「人工知能関連技術の研究開発及び活用の推進に関する法律(AI法)」が成立し、同年9月に全面施行されました。その後、AIの適正な研究開発・活用に向けた指針の整備やAI基本計画の策定も進み、企業にとってAIガバナンスは単なる社内マナーではなく、経営やリスク管理の一部として捉えるべきテーマになっています。
もっとも、こうした制度が「特定の生成AIサービスを使ってよいか」を企業ごとに細かく決めてくれるわけではありません。企業側では、国のガイドラインや指針を踏まえつつ、自社が扱う情報、業務、契約、利用環境に応じた具体的なルールへ落とし込む必要があります。
そのため、最初に決めるべきことは「AIを使うか、使わないか」ではなく、「どの業務で、どの情報を、どの条件なら扱ってよいか」です。
情報漏洩リスクは「悪意」ではなく「便利さ」から起きる
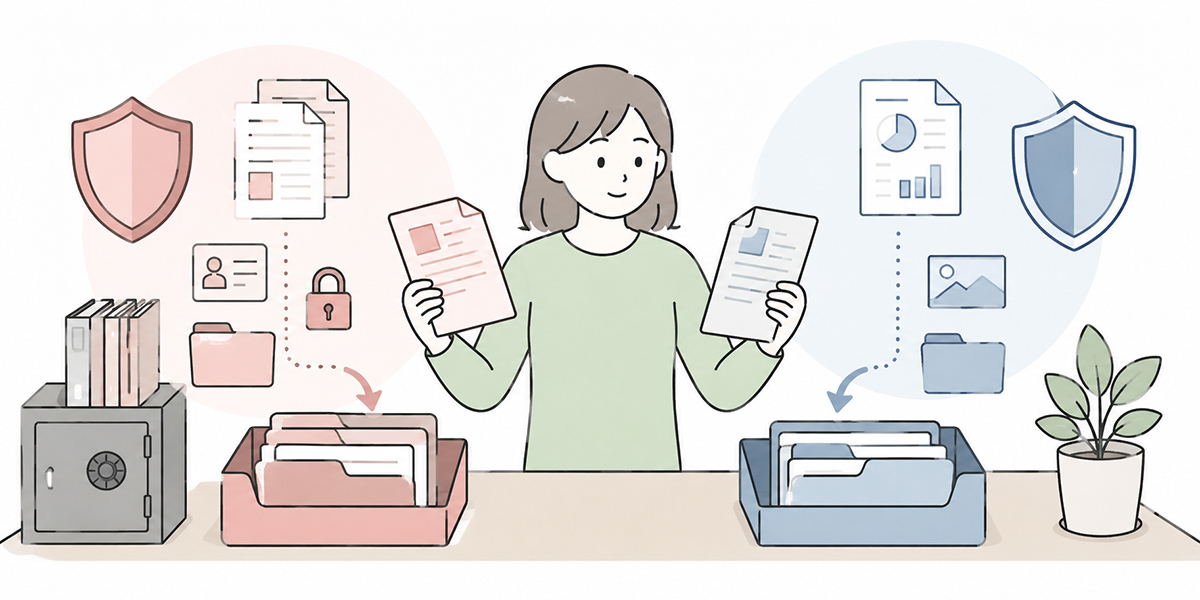
生成AIの社内利用で最も分かりやすいリスクは、情報漏洩です。
ここで注意したいのは、情報漏洩は「悪意ある持ち出し」だけで起きるものではないという点です。日常業務では、便利さを優先した結果、本人に悪気がないままリスクの高い情報を入力してしまうケースが起こり得ます。
たとえば、顧客との商談メモをそのままAIに要約させる、契約書の全文を外部AIサービスに貼り付けてリスク箇所を聞く、社内会議の録音データや議事録を参加者名入りで要約する、未公開の新サービス情報をもとにプレスリリース案を作る、人事異動や評価、退職予定者に関するメモをAIで整理する、といった場面です。
これらは、業務上は自然な使い方です。だからこそ、「禁止」とだけ伝えるのではなく、情報の種類ごとに扱いを分ける必要があります。
情報は3段階で分ける
社内ルールの出発点としては、情報を大きく次の3段階に分けると整理しやすくなります。
| 区分 | 例 | 生成AIでの扱い |
|---|---|---|
| 利用しやすい情報 | 公開情報、一般的な業務ノウハウ、社外公開済み資料 | 利用可。ただし出典や正確性は確認する |
| 条件付きで扱う情報 | 社内規程、業務マニュアル、社内会議メモ、顧客とのやり取りの要約 | 会社が利用を承認したAI環境でのみ扱う。利用前に、入力データの保存期間、AIモデルの学習への利用有無、アクセス権限、ログ管理、契約上のデータ取扱条件を確認し、必要に応じてマスキングする。 |
| 入力しない情報 | 機微情報、未公開財務情報、M&A情報、個人が特定できる情報、顧客の秘密情報 | 原則として入力禁止。例外が必要な場合は専門部署に確認する |
社内ルールでは「何となく危ないもの」ではなく、情報の種類を具体的に言語化することが重要です。
筆者の経験では、ここを曖昧にしたままAI導入を進めると、あとから必ず現場で迷いが出ます。逆に、情報区分が整理されている会社では、AI活用の議論が前に進みやすくなります。利用可否の会話が「怖いかどうか」ではなく、「どの区分に該当するか」で進むからです。
弊社が提供するKanataを利用する場合も、この情報区分の考え方は重要です。KanataはAIチャット、AI要約、eラーニングなどをまとめて使える業務支援プラットフォームですが、どの情報をどのプロジェクトで扱うかは、企業側の運用設計に左右されます。利用するツールにかかわらず、まずは自社の情報分類を決めることが出発点です。
マスキングは「名前を消す」だけでは足りない
情報漏洩対策として、よく使われるのがマスキングです。マスキングとは、個人や企業を特定できる情報を削除したり、抽象的な表現に置き換えたりする処理を指します。
ただし、マスキングは氏名を消すだけでは不十分です。会社名、部署名、役職、金額、日付、案件名などが組み合わさると、個人や取引先が特定できる場合があります。
たとえば、次のように置き換えると安全性を高めやすくなります。
| 元の情報 | 置き換え例 |
|---|---|
| 山田太郎さん | 担当者A |
| 株式会社〇〇 | 製造業の中堅企業 |
| 3,200万円 | 数千万円規模 |
| 2026年5月13日 | 2026年5月中旬 |
| 東日本営業部 第一課 | 営業部門の一部署 |
| 契約書番号、社員番号、電話番号 | 削除 |
社内ルールでは、「個人情報を入れない」と書くだけでなく、具体的に何をどう置き換えるのかまで示すと、現場で運用しやすくなります。
現場の人は、必ずしもセキュリティや法務の専門家ではありません。だからこそ、「気をつけてください」ではなく、「この場合はこう置き換えてください」と示す必要があります。小さな例示の積み重ねが、結果的に大きな事故を防ぎます。
著作権リスクは「入力」と「出力」の両方で見る
生成AIの著作権リスクは、少し分かりにくい領域です。
情報漏洩や個人情報は「入れてはいけない情報」を比較的イメージしやすい一方で、著作権は「入力」と「出力」の両方に注意が必要です。
筆者が相談を受ける中でも、著作権については「AIが作ったものなら自由に使えるのではないか」「ネット上にある文章なら読み込ませてもよいのではないか」といった誤解が残っている場面があります。
しかし、業務利用では、そのような大ざっぱな理解では危険です。特に、マーケティング、営業資料、研修教材、オウンドメディア、ホワイトペーパーなどを扱う部門では、著作権の観点を最初からルールに含めておく必要があります。
文化庁は、生成AIと著作権の関係について、判例や裁判例の蓄積がまだ十分ではないことを前提に、「AIと著作権に関する考え方について」などを通じて論点を整理しています。また、2025年以降も相談事例や最新状況に関する資料が公開されています。
第三者の著作物は、権利関係と利用条件を確認してから入力する
まず注意したいのは、AIに読み込ませる素材です。
たとえば、有料記事を全文コピーして要約させる、書籍の一章を貼り付けて研修資料に再構成させる、他社のホワイトペーパーを読み込ませて自社資料のたたき台を作る、競合企業の提案資料をもとに自社提案書の構成を作る、Web上の画像やイラストを読み込ませて似たデザインを生成させる、といった使い方には注意が必要です。
これらは、業務効率化のために起こりやすい使い方です。しかし、素材の権利関係や利用条件を確認しないままAIに入力すると、著作権や契約上の問題につながる可能性があります。
第三者の著作物だから一律に入力できないという意味ではありません。ただし、著作権法上許容される利用かどうかに加えて、サービスの利用規約、購入・契約したコンテンツの利用条件、社内利用の目的なども確認する必要があります。
社内ルールでは、少なくとも次の区分を設けるとよいでしょう。
| 素材の種類 | 扱い方 |
|---|---|
| 自社で作成した社内資料 | 機密区分を確認したうえで利用 |
| 自社が権利を持つ公開資料 | 利用可。ただし最新版か確認 |
| 公開Webページ | URL参照や要約は可能な場合があるが、全文コピーは慎重に扱う |
| 有料記事・書籍・他社資料 | 原則として全文入力しない。利用許諾や契約条件を確認 |
| 画像・音声・動画 | 権利者、利用許諾、肖像権・パブリシティ権なども確認 |
筆者が実務でよく伝えるのは、「AIに入れる前に、その素材を社内の別の人へ自由に配ってよいかを考えてください」ということです。もし自由に配れない素材であれば、AIに投入することにも慎重になるべきです。
AI出力をそのまま公開しない
次に、AIが出した文章や画像をどう使うかという問題があります。
AIの出力は、必ずしも完全にオリジナルであるとは限りません。既存の文章や表現に似た内容が含まれる可能性があります。また、出力された内容が事実と異なる場合や、根拠のない断定を含む場合もあります。
そのため、次のような利用では、人の確認が必要です。
- 社外向けの記事やホワイトペーパー
- 広告文、LP、メールマガジン
- 営業資料、提案書
- 研修教材
- 契約書、規程、社内通達
- 画像、ロゴ、キャッチコピー
特にマーケティングや営業資料では、「それらしい表現」が出るほど便利に感じます。しかし、既存コンテンツに似ていないか、事実確認ができているか、自社の表現ルールに合っているかは、必ず人が確認すべきです。
社内ルールでは、「AI出力をそのまま社外公開しない」という原則を置き、公開前に確認する項目をチェックリスト化しておくとよいでしょう。
筆者自身、AIを使って文章の構成や初稿を作ることはあります。しかし、そのまま外に出すことはありません。言葉の温度、事実の精度、読み手への配慮、自社らしさ。そうした最後の調整は、まだ人間の仕事として残すべき領域です。
個人情報リスクは「氏名の有無」だけで判断しない
生成AIの利用で特に慎重に扱うべきなのが、個人情報です。
個人情報保護委員会は、生成AIサービスの利用について注意喚起を行っており、個人情報を含むデータを生成AIサービスに入力する場合には、個人情報保護法上の義務や利用目的、第三者提供、委託関係などを踏まえた確認が必要になります。
生成AIだから特別な別ルールが必要というより、個人情報保護法上の利用目的、安全管理措置、委託・第三者提供などの既存の管理ルールを、AIサービスのデータ処理の仕組みに当てはめて確認することが基本になります。
企業の現場では、次のような情報が個人情報に該当しやすくなります。
- 氏名
- メールアドレス
- 電話番号
- 住所
- 社員番号
- 顧客ID
- 顔写真
- 音声
- 評価コメント
- 勤怠情報
- 健康情報
- 家族情報
- 相談内容
- 問い合わせ履歴
また、単体では個人を特定できない情報でも、複数の情報を組み合わせることで個人が分かる場合があります。
たとえば、「営業部の30代女性マネージャー」「2026年4月に育休から復帰」「大阪支店勤務」といった情報が組み合わされば、社内では誰のことか分かってしまう可能性があります。
個人情報の怖さは、ひとつひとつの情報が小さく見えることです。名前を消したから大丈夫、部署だけなら大丈夫、年齢だけなら大丈夫。そう思っていても、組み合わせると十分に特定できてしまうことがあります。
個人情報を扱いやすい業務ほど注意する
個人情報リスクが高いのは、次のような業務です。
| 業務 | 起きやすいリスク |
|---|---|
| 人事評価 | 評価コメントや異動情報を入力してしまう |
| 採用 | 候補者の履歴書、面接メモ、評価情報を入力してしまう |
| カスタマーサポート | 顧客名、連絡先、問い合わせ履歴を入力してしまう |
| 営業 | 担当者名、商談履歴、契約条件を入力してしまう |
| 1on1・マネジメント | 部下の悩み、健康状態、家庭事情を入力してしまう |
| 研修 | 受講履歴、テスト結果、アンケート回答を入力してしまう |
これらの業務は、生成AIとの相性が悪いわけではありません。むしろ、要約、分類、文章化、問い合わせ対応などに活用しやすい領域です。
ただし、扱う情報の中に個人情報が含まれやすいため、マスキング、利用環境、権限管理、ログ管理を前提にする必要があります。
筆者が特に注意したいと感じるのは、人事評価や1on1メモのような「本人の感情や評価に近い情報」です。業務効率化のためにAIで整理したくなる気持ちは理解できます。しかし、そこには本人の信頼やプライバシーが深く関わります。使う場合は、通常の文章作成以上に慎重な設計が必要です。
例外時の相談先まで決める
個人情報については、「入力禁止」と書くだけでは現場が止まります。
たとえば、人事部門やカスタマーサポート部門では、業務上どうしても個人に関わる情報を扱います。そのため、社内ルールには次のような例外時の流れも含めると運用しやすくなります。
- 個人情報を含む可能性がある場合は、まずマスキングする
- マスキングしても個人が特定される場合は、入力しない
- 業務上どうしても必要な場合は、情シス・法務・個人情報管理責任者に相談する
- 承認された環境・用途・範囲でのみ利用する
- 利用後のログ、出力物、保存先を確認する
「迷ったら使わない」だけではなく、「迷ったら誰に確認するか」を明記することが大切です。
現場でルールが機能しない原因のひとつは、相談先がないことです。ルール上は慎重に扱うべきと書かれていても、実際に誰へ聞けばよいか分からない。すると、社員は自分で判断するか、利用自体を諦めます。どちらも、組織としては望ましい状態ではありません。
AI出力の責任をAIに渡さない
生成AIのリスクは、入力情報だけではありません。出力された内容をどう扱うかも重要です。
AIは、自然な文章を作ることが得意です。そのため、読みやすく、もっともらしく、説得力のある文章を出すことがあります。しかし、その内容が正しいとは限りません。
特に人の確認が必要な出力
次のような出力は、AIの回答をそのまま使わないことが重要です。
| 出力内容 | 確認すべきこと |
|---|---|
| 契約書レビュー | 法務確認が必要。AIは最終判断者ではない |
| 法令・規制に関する説明 | 最新情報、条文、専門家確認が必要 |
| 個人情報に関する判断 | 個人情報保護法、社内規程、委託関係の確認が必要 |
| 著作権に関する判断 | 権利関係、利用許諾、類似性の確認が必要 |
| 数値を含む資料 | 原典、算出条件、単位、期間を確認 |
| 顧客向け提案 | 事実、契約条件、表現の妥当性を確認 |
| 社外公開記事 | 著作権、引用、事実確認、ブランドトーンを確認 |
AIに任せやすいのは、下書き、整理、要約、比較、論点出しです。一方で、最終判断、対外責任、法的判断、顧客への約束は人が担うべきです。
筆者は、AIを「優秀な壁打ち相手」と表現することがあります。こちらが材料を渡せば、論点を整理し、文章を整え、複数案を出してくれる。しかし、最終的に「この表現で出す」「この判断で進める」と決めるのは人間です。そこまでAIに渡してしまうと、業務の責任構造が崩れてしまいます。
「AIが言ったから」は免責にならない
社外に出した資料、顧客に送ったメール、社員に展開した規程解釈について、後から誤りが分かった場合、「AIがそう言ったから」は説明になりません。
社内ルールでは、次の原則を明文化しておくとよいでしょう。
- AI出力の最終責任は利用者または承認者が負う
- 社外公開前には人がレビューする
- 数字、日付、固有名詞、引用は原典に当たる
- 法務、労務、会計、セキュリティ、医療、安全に関わる判断は専門部署に確認する
- AI出力をそのままコピーせず、自社の文脈に合わせて編集する
これは、AI利用を制限するためではありません。むしろ、安心して業務利用するための前提条件です。
AIは、文章を速く作ることができます。しかし、信頼を速く回復することはできません。誤った情報を出した後に、顧客や社員からの信頼を取り戻すには時間がかかります。だからこそ、出力レビューは面倒な手続きではなく、AI活用を長く続けるための保険だと考えるべきです。
社内ルール作りは3つの表から始める
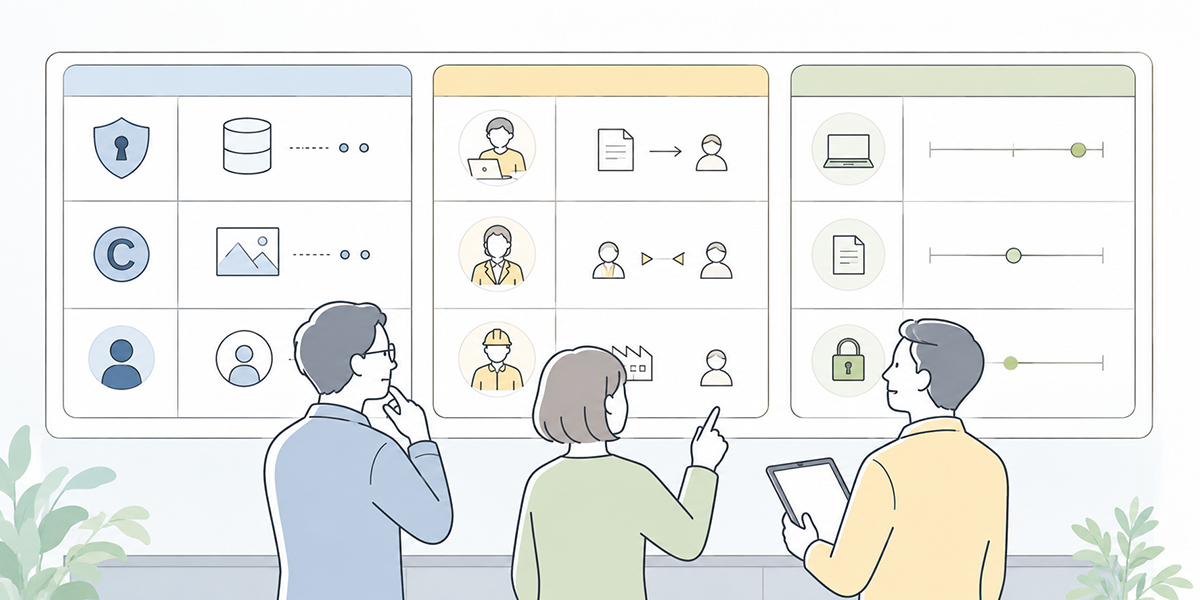
生成AIの社内ルールを最初から完璧に作ろうとすると、議論が止まりやすくなります。
情シスは安全性を重視し、法務は権利や契約を見ます。現場は業務効率を求め、経営は競争力や投資対効果を考えます。どの視点も正しいため、最初から細かい規程文に落とし込もうとすると、合意形成に時間がかかります。
初期段階では、細かな規程文を作るよりも、現場がすぐに使える表を用意するほうが実務に向いています。ここでは、共通パートとして最低限作っておきたい3つの表を紹介します。
入力してよい情報・条件付き情報・禁止情報
まずは、AIに入力してよい情報を分類します。
| 区分 | 入力可否 | 例 | 条件 |
|---|---|---|---|
| 公開情報 | 可 | 公式サイト、公開IR、公開済みプレスリリース | 出典と更新日を確認 |
| 社内一般情報 | 条件付き可 | 業務マニュアル、社内規程、FAQ | 社内承認済みの環境で扱う |
| 顧客関連情報 | 条件付き可 | 商談メモ、提案書、問い合わせ内容 | 顧客名・担当者名・金額をマスキング。契約条件を確認 |
| 個人情報 | 原則不可 | 氏名、連絡先、社員番号、評価、履歴書 | 原則入力しない。必要時は承認制 |
| 機微情報 | 不可 | 健康情報、信条、マイナンバー、口座情報 | 入力禁止 |
| 未公開重要情報 | 不可 | 決算、M&A、人事異動、新製品情報 | 入力禁止 |
この表があるだけで、現場は「何を確認すればよいか」を判断しやすくなります。
用途別の利用可否
次に、業務用途ごとに利用可否を整理します。
| 用途 | 利用可否 | 注意点 |
|---|---|---|
| メール下書き | 可 | 顧客名、契約条件、個人情報を必要以上に入れない |
| 議事録要約 | 条件付き可 | 参加者名、未公開情報、顧客情報を確認 |
| 社内規程FAQ | 条件付き可 | 最新版の規程を使う。根拠がない場合は答えさせない |
| 契約書レビュー | 条件付き可 | 一次整理に限定。最終判断は法務 |
| 採用書類整理 | 慎重に扱う | 候補者情報を含むため、原則マスキング・承認制 |
| 人事評価コメント | 慎重に扱う | 評価情報・個人情報を含むため、利用範囲を限定 |
| マーケティング記事作成 | 可 | 著作権、引用、事実確認、誇大表現に注意 |
| 顧客向け提案書 | 条件付き可 | 顧客固有情報、契約条件、数値根拠を確認 |
用途別に整理すると、部署ごとの会話がしやすくなります。
情シスは利用環境やアクセス管理を見ます。法務は契約、著作権、個人情報を見ます。現場管理職は業務効率と定着を見ます。視点が違うため、共通の表があると議論を進めやすくなります。
筆者が支援先でこの表を作るときは、まず完璧さを求めません。最初は「暫定版」で十分です。むしろ、現場の問い合わせや実際の利用ケースをもとに、月次または四半期ごとに更新していくほうが現実的です。
出力を使う前のチェックリスト
最後に、AI出力を使う前のチェック項目を用意します。
| 確認項目 | チェック内容 |
|---|---|
| 事実確認 | 数字、日付、固有名詞は原典と一致しているか |
| 著作権確認 | 既存記事、他社資料、書籍表現に過度に似ていないか |
| 個人情報確認 | 氏名、連絡先、個人が特定される情報が残っていないか |
| 機密情報確認 | 未公開情報、顧客情報、契約条件が含まれていないか |
| 表現確認 | 誇大表現、断定、差別的表現、不適切表現がないか |
| 専門部署確認 | 法務、労務、会計、セキュリティなどの確認が必要か |
| 承認確認 | 社外公開前に責任者が確認したか |
このチェックリストは、社外公開物だけでなく、社内全体に配布する文書にも使えます。
特に生成AIの出力は、文章として自然に見えるため、確認を飛ばしやすい点に注意が必要です。
Kanataを使う場合に整理しておきたい運用ポイント
ここまで述べた考え方は、特定のツールに限らず、生成AIを業務利用する企業全般に必要なものです。そのうえで、Kanataを利用する場合は、プロジェクト、アプリ、ライブラリの設計を社内ルールと結びつけることが重要です。
Kanataは、AIチャット、AI要約、eラーニングなどをひとつの場所で扱える業務支援プラットフォームです。AIへの質問、文章作成、アイデア出し、会議録音や議事メモの要約、動画を起点にした研修コンテンツの配信などを行えます。
また、Kanataでは、プロジェクトごとに利用者、データ、アプリを整理できます。つまり、単にAIチャットを使うだけではなく、「誰が、どのプロジェクトで、どの情報を扱うか」を設計しやすい構造があります。
情報区分に合わせてプロジェクトを分ける
生成AIの利用では、「誰がどの情報を見てよいか」が重要です。
Kanataでは、プロジェクトを業務単位のグループとして作成し、メンバーや権限をプロジェクトごとに管理できます。
そのため、すべての業務を1つのプロジェクトにまとめるのではなく、情報の機密性や関係者に合わせて分けることが考えられます。
| プロジェクト例 | 扱う情報 | 注意点 |
|---|---|---|
| 全社AI活用研修 | 公開情報、一般的な研修資料 | 全社員向けにしやすい |
| 営業提案支援 | 商談メモ、提案書、顧客課題 | 顧客情報のマスキングと権限管理が必要 |
| 人事・総務FAQ | 社内規程、FAQ | 最新版管理と回答根拠の確認が必要 |
| 法務レビュー支援 | 契約書、条項案 | 一次整理に限定し、最終判断は法務 |
| 経営企画 | 未公開数値、戦略情報 | 生成AI利用の可否自体を慎重に判断 |
プロジェクトを分ける基準は、「同じ情報を見てよい関係者かどうか」です。
筆者は、この考え方を非常に重要だと考えています。AI活用の成否は、モデルの性能だけで決まるわけではありません。組織内の情報の置き場所、アクセス権限、更新責任者が曖昧なままでは、どれだけ良いAIを使っても運用が崩れます。
ライブラリ登録前に確認する
Kanataでは、プロジェクトライブラリにAI設定、プロンプト、学習データを保管できます。
これは、社内のナレッジを再利用するうえで便利な仕組みです。一方で、登録する情報の確認が不十分だと、機密情報や古い資料が再利用され続けるリスクもあります。
そのため、ライブラリ登録前には次の確認を行うとよいでしょう。
- 登録してよい情報区分か
- 個人情報や機微情報が含まれていないか
- 顧客名、担当者名、金額などが必要以上に残っていないか
- 資料が最新版か
- 誰が利用できるプロジェクトに登録されるか
- 登録後の更新責任者は誰か
生成AIの精度を高めるには、学習データやプロンプトの整備が重要です。しかし、便利さだけを優先すると、誤った情報や扱うべきでない情報を組織内で広げてしまう可能性があります。
筆者は、AI活用を「データを入れれば賢くなる」という単純な話では見ていません。入れるデータの質、管理の仕方、更新の仕組みまで含めて設計して初めて、業務で使い続けられるAIになります。
研修とセットで定着させる
Kanataにはeラーニング機能があり、動画コンテンツを中心に社内研修や自己学習を行うことができます。受講中にAIへ質問できる機能もあるため、生成AI利用ルールの教育にも応用しやすい構造があります。
生成AIの社内ルールは、規程として配布するだけでは定着しません。
たとえば、次のような研修コンテンツにすると、現場で使いやすくなります。
- 生成AIに入れてよい情報・入れてはいけない情報
- 著作権で注意すべき入力素材と出力物
- 個人情報を含む業務でのマスキング例
- AI出力を社外に出す前のチェックリスト
- インシデントが起きたときの報告フロー
- 部署別の具体的な利用シーン
ただし、ツールがあれば教育が不要になるわけではありません。ルール、研修、現場での相談先、定期的な見直しを組み合わせて、初めて運用として機能します。
インシデント時の動きを決めておく
社内ルールでは、予防策だけでなく、問題が起きたときの動きも決めておく必要があります。
どれだけ注意しても、誤入力や誤公開を完全にゼロにすることは難しいためです。
たとえば、機密情報を誤ってAIに入力した場合、社員が「怒られるのでは」と思って報告をためらうと、対応が遅れます。むしろ、早く報告したほうが被害を小さくできるという文化を作ることが重要です。
社内ルールには、次の項目を入れておくとよいでしょう。
- 誤入力に気づいたら、ただちに利用を止める
- 何を、いつ、どのAIサービスに入力したか記録する
- 画面キャプチャやログなど、確認に必要な情報を残す
- 情報セキュリティ担当者、上長、法務などに報告する
- 影響範囲を確認する
- 必要に応じて取引先や本人への連絡を検討する
- 再発防止策をルールや研修に反映する
大切なのは、インシデント対応を「個人の失敗の追及」にしないことです。
筆者は、現場で新しい技術が定着するかどうかは、失敗したときの扱いで決まると考えています。失敗を隠したくなる組織では、リスクは地下に潜ります。反対に、早く報告できる組織では、リスクを学習に変えられます。
生成AIは新しい業務インフラになりつつあります。だからこそ、報告しやすい仕組みと、改善し続ける運用が必要です。
まず作るべき社内ルールの最小セット
生成AIの社内ルールは、最初から分厚い規程にする必要はありません。
むしろ、初期段階では、現場がすぐに使える最小セットから始めるほうが定着しやすくなります。
共通パートとして、まず用意したいのは次の5つです。
入力禁止情報リスト
最低限、次の情報は入力禁止または承認制にします。
- 機微情報
- マイナンバー
- 健康情報
- 口座情報
- 未公開財務情報
- M&A情報
- 未公開の人事異動
- 顧客の秘密情報
- 個人が特定できる情報
- 契約上、第三者提供が制限される情報
このリストは、最初から細かく作り込みすぎる必要はありません。まずは、絶対に入れてはいけない情報を明確にすることが重要です。
マスキングルール
次に、情報を置き換えるルールを示します。
- 氏名は「担当者A」「顧客担当者」などに置き換える
- 会社名は「製造業の中堅企業」などに置き換える
- 金額は「数千万円規模」などに丸める
- 日付は「2026年5月中旬」などに抽象化する
- 連絡先、住所、社員番号、口座番号は削除する
- 組み合わせで特定される情報も削る
ここは、実際の業務文書をもとにサンプルを作ると定着しやすくなります。営業メモ、人事メモ、問い合わせログ、議事録など、部署ごとの例を用意すると、現場は自分ごととして理解できます。
用途別の利用可否表
部署ごとに利用可否を決めます。
たとえば、メール下書きや一般的な文章校正は利用しやすい領域です。一方で、契約書レビュー、採用、人事評価、顧客対応履歴の分析は、条件付き利用または承認制にする必要があります。
用途別に整理すると、現場は「この仕事では使ってよいのか」を判断しやすくなります。
出力レビューのチェックリスト
AI出力を利用する前には、次の観点で確認します。
- 事実は正しいか
- 数字に単位、期間、前提があるか
- 引用元は確認できるか
- 著作権上問題のある表現がないか
- 個人情報や機密情報が残っていないか
- 誇大表現や断定表現がないか
- 専門部署の確認が必要ではないか
AI出力のレビューは、単なる校正ではありません。責任を持って利用できる状態に整える工程です。
相談先とインシデント報告フロー
最後に、迷ったときの相談先を決めます。
- 情報漏洩が不安な場合
- 情報システム部、セキュリティ担当
- 著作権が不安な場合
- 法務、広報、コンテンツ責任者
- 個人情報が不安な場合
- 個人情報管理責任者、法務
- 業務利用の可否が不安な場合
- 部門長、AI活用推進担当
- 誤入力した場合
- 上長、情シス、法務へ速やかに報告
「迷ったら誰に聞くか」が決まっていれば、現場は判断を抱え込まずに済みます。
筆者は、AI導入において「相談できる空気」はかなり重要だと考えています。ルールは紙に書かれた瞬間ではなく、社員が迷ったときに質問できた瞬間から機能し始めます。
まとめ
生成AIの業務利用では、情報漏洩、著作権、個人情報の3つが特に問題になりやすい領域です。
ただし、これらのリスクがあるからといって、生成AIを一律に禁止すればよいわけではありません。禁止だけでは、現場の業務効率化は進まず、個人判断による利用が見えにくくなる可能性があります。
重要なのは、次のような判断基準を作ることです。
- どの情報は入力してよいか
- どの情報はマスキングすれば扱えるか
- どの情報は入力してはいけないか
- AI出力をどの範囲まで使ってよいか
- 社外公開前に誰が確認するか
- 判断に迷ったとき誰に相談するか
- 誤入力が起きたとき、どう報告するか
生成AIは、メール、議事録、調査、提案書、契約書の一次整理、社内FAQ、研修コンテンツなど、幅広い業務で活用できます。一方で、AIは判断責任を肩代わりするものではありません。社内ルール、教育、権限管理、レビュー体制を整えて初めて、安心して使える業務基盤になります。
まずは、完璧な規程を作るよりも、入力情報の分類、用途別の利用可否、出力レビューのチェックリストから始めることが現実的です。
筆者は、生成AIの導入を「ツールを入れる話」だけで終わらせるべきではないと考えています。重要なのは、AIを使うことで、現場の判断が軽くなり、組織の知識が扱いやすくなり、顧客や社員への責任をより丁寧に果たせるようになることです。
自社の業務で、どこまでをAIに任せ、どこからを人が判断するのか。その線引きを組織で共有することが、生成AI活用の第一歩になります。
Q&A
生成AIの社内ルールは、最初から詳細な規程として作るべきですか?
最初から詳細な規程を作るよりも、入力禁止情報、条件付き利用情報、用途別の利用可否、出力レビューのチェックリストから始めるほうが現実的です。運用しながら、問い合わせやトラブル事例をもとに更新していく形が定着しやすくなります。
顧客名や担当者名を削除すれば、商談メモをAIに入れても問題ありませんか?
氏名や会社名を削除しても、業界、役職、金額、時期、案件内容の組み合わせで顧客や個人が特定される場合があります。商談メモを扱う場合は、顧客情報の機密性、契約条件、社内の利用環境を確認したうえで、必要な範囲だけをマスキングして使うべきです。
AIが作った文章は、そのまま社外公開してもよいですか?
そのまま公開するのは避けるべきです。AI出力には、事実誤認、根拠のない断定、既存表現との類似、個人情報や機密情報の残存が含まれる可能性があります。社外公開前には、事実確認、著作権確認、表現確認、責任者レビューを行う必要があります。
個人情報を含む業務では、生成AIを使わないほうがよいですか?
一律に使えないわけではありません。ただし、人事評価、採用、問い合わせ対応、1on1メモなどは個人情報を含みやすいため、マスキング、承認制、アクセス制限、ログ管理、相談先の明確化が必要です。判断に迷う場合は、法務や個人情報管理責任者に確認する運用を設けるべきです。
Kanataのような社内向けAI基盤を使えば、情報漏洩や著作権の問題は解決しますか?
ツールだけで全てのリスクが解決するわけではありません。Kanataのようにプロジェクトやライブラリを分けて運用できる基盤は、情報の置き場所や利用者の整理に役立ちます。ただし、どの情報を登録するか、誰に権限を与えるか、AI出力をどう確認するかは、企業側のルールと運用設計が必要です。